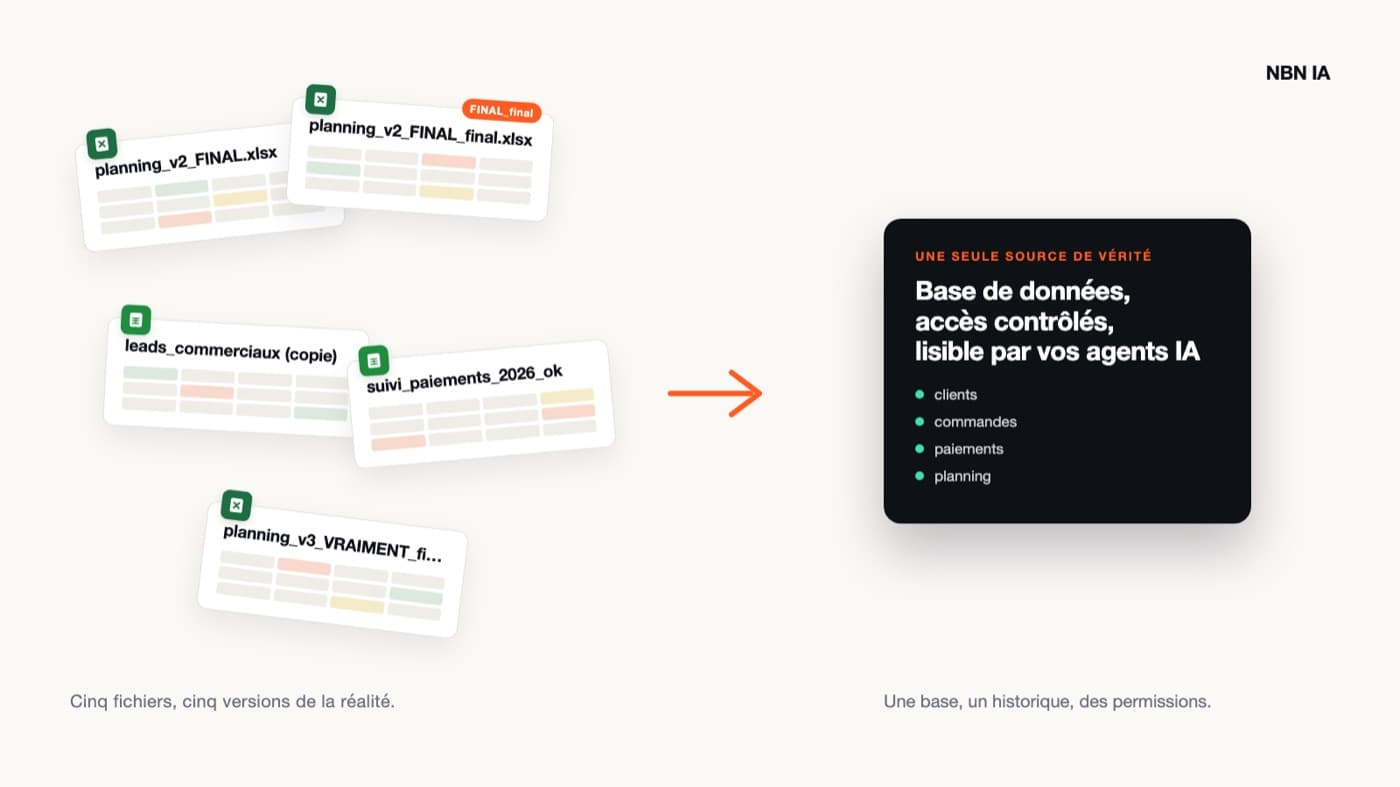
Il y a un fichier, quelque part dans votre entreprise, qui s'appelle « planning_v2_FINAL_final.xlsx ». Tout le monde le connaît. Personne n'est vraiment sûr que ce soit la bonne version. Et pourtant toute l'équipe continue de le mettre à jour, chacun de son côté, en espérant que ça ne parte pas en vrille.
Ce n'est pas un cas isolé. C'est la norme dans la plupart des PME.
Le tableur, solution universelle… et problème universel
Excel et Google Sheets ont une qualité rare : ils s'adaptent à tout. Un planning, un suivi client, une compta simplifiée, un CRM de fortune, un stock, un rétroplanning projet — tout finit dans un tableur, parce que c'est rapide, gratuit, et que tout le monde sait plus ou moins s'en servir.
Le problème, ce n'est pas l'outil. C'est ce qui se passe quand personne ne pose de règles claires sur son utilisation. Au bout de quelques mois, une PME typique se retrouve avec :
- un Sheet pour les leads commerciaux
- un autre pour le suivi des paiements
- un troisième, partagé par erreur avec la mauvaise personne, pour les plannings d'équipe
- des formules que seule une personne comprend, et qui vient de partir en congés
- des doublons de données entre plusieurs fichiers qui ne se parlent jamais
Chaque fichier devient un silo. Chaque silo demande une gymnastique mentale pour savoir où chercher l'information, laquelle est à jour, et qui a le droit d'y toucher. On ne gère plus des données, on gère une collection de fichiers qui se contredisent.
Le vrai coût, c'est la charge mentale
On sous-estime souvent le coût réel de cette organisation. Ce n'est pas le prix d'une licence, c'est le temps perdu à chercher la bonne version, à recopier une information d'un fichier à l'autre, à corriger une erreur de saisie qui traîne depuis trois semaines.
C'est aussi un frein direct à tout ce qu'on peut faire avec l'IA aujourd'hui. Un assistant intelligent ou un agent d'automatisation a besoin d'une donnée fiable et accessible par une seule porte d'entrée pour être vraiment utile.
Une précision importante ici : le problème n'est pas le format du fichier en lui-même. Un Google Sheet propre, avec une structure claire, une seule source de vérité et des accès contrôlés, peut très bien être lu et exploité par une IA — via une API, une automatisation, un agent. Ce qui bloque, ce n'est pas « Excel », c'est l'absence de discipline : cinq fichiers qui racontent chacun une version différente de la réalité, et personne n'est plus capable de dire lequel a raison.
Ce que change l'arrivée de l'IA (et d'outils comme Supabase)
Ce qui est nouveau, ce n'est pas l'idée d'avoir une vraie base de données plutôt qu'un tableur mal tenu — ça, les entreprises le savent depuis longtemps. Ce qui est nouveau, c'est que c'est devenu accessible sans mobiliser une équipe de développeurs pendant plusieurs mois.
Des outils comme Supabase permettent aujourd'hui de poser une base de données structurée, avec des règles claires sur qui peut lire ou modifier quoi, bien plus rapidement qu'avec une approche de développement classique. Et surtout : cette base peut être branchée directement à des outils d'IA. Un agent peut interroger la base, mettre à jour une commande, répondre à un client, générer un rapport — sans que quelqu'un ait besoin d'ouvrir un fichier pour vérifier une info à la main.
À l'inverse, il faut être honnête : une base de données mal pensée, sans réflexion sur sa structure, peut recréer exactement le même chaos qu'un tableur mal tenu. La technologie ne remplace pas la rigueur — elle la rend juste plus facile à mettre en place et à maintenir dans la durée.
La vraie bascule tient dans quelques points concrets :
- Une seule source de vérité, au lieu de plusieurs fichiers qui racontent chacun une version différente de la réalité
- Des permissions réelles, plutôt qu'un partage de lien où tout le monde peut tout modifier
- Une donnée exploitable par une IA, capable de répondre à une question ou de déclencher une action automatiquement
- Un historique traçable, plutôt que des versions de fichiers qui s'écrasent les unes les autres
Le vrai frein n'est pas technique
La technologie pour structurer proprement ses données existe, elle est mature, et elle n'est plus réservée aux grandes entreprises. Le vrai frein, la plupart du temps, c'est l'habitude. C'est cette gymnastique de l'esprit qu'on a fini par intégrer sans s'en rendre compte : « je sais où chercher », « je sais comment contourner le bug de la formule », « je sais qui a la bonne version ».
Cette habitude rassure, parce qu'elle est familière. Mais elle a un coût réel, et elle limite ce que l'IA peut réellement apporter à l'entreprise. On ne peut pas brancher un agent intelligent sur un système qui n'existe que dans la tête de la personne qui a construit le fichier.
La question à se poser n'est donc pas « Excel ou base de données ». C'est : est-ce que mes données ont une seule source de vérité, propre et accessible — quel que soit l'outil qui la porte ?
Changer de système de classement n'est pas un caprice technique. C'est une condition pour que l'IA devienne réellement utile dans une entreprise, et pas seulement un gadget testé sur un cas isolé pendant que le cœur de l'activité continue de tourner sur des fichiers envoyés par email.
La bonne nouvelle : on n'a pas besoin de tout reconstruire d'un coup. La transition peut se faire progressivement, un flux à la fois, en commençant par les données qui posent le plus de problèmes aujourd'hui.